Índice do fórum » Projetos » Figurinhas Copa 2026
| Autor | Mensagem |
|---|---|
| joshazze Administrador Registrado em: Fev 2026 Mensagens: 28 Localização: Belo Horizonte |
Enviado em: 15 Mai 2026
Assunto: Figurinhas Copa 2026
ContextoO álbum da Copa de 2026 tem 980 figurinhas, 912 normais e 68 douradas metalizadas. Cada pacote traz 7 e custa 7 reais. É a primeira Copa com 48 seleções, e saber quanto falta deixou de ser conta de cabeça. Quem coleciona costuma usar uma lista no papel ou uma planilha, e as duas falham no mesmo momento, na conferência, quando há sete figurinhas na mão e é preciso descobrir se cada uma é nova ou repetida. Sete consultas por pacote. Abrir o pacote leva quinze segundos. O que eu fizUm app instalável que responde três perguntas: o que eu tenho, o que falta e o que está repetido para trocar. E quanto já se gastou. O escaneamento é o centro do app: em vez de digitar o código de cada figurinha, você tira uma foto e ele lê. O reconhecimento roda no navegador, e não no servidor, então funciona mesmo com conexão ruim. Para o iOS, o app é empacotado com Capacitor, que dá acesso à câmera nativa mantendo o mesmo código da versão web. Por trás há um backend próprio: FastAPI em Python, PostgreSQL 16 e Caddy como proxy reverso, que cuida do HTTPS sozinho via Let's Encrypt. Ele guarda o catálogo oficial, as coleções e o histórico, para que o álbum não dependa do navegador de um aparelho. Como funcionaO app fotografa o verso da figurinha, extrai o texto e compara o resultado com o dicionário de códigos oficiais usando comparação aproximada, já que o OCR erra.
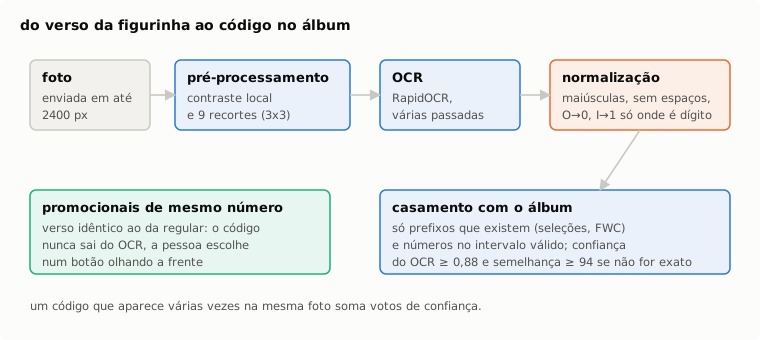
Do verso da figurinha ao código no álbum. O que mais pesa no resultado é a normalização antes da comparação. Os códigos da Panini são letras seguidas de dígitos, sem separador, então qualquer espaço lido pelo reconhecedor vem do papel, da luz ou do ângulo e não carrega informação. O que aprendiO primeiro caso foi "COL 4", que não casava com "COL4". A foto estava nítida. O app respondia "não lido". Minha normalização juntava espaços múltiplos em um só, como se faz com texto comum. Aqui o espaço era ruído. A comparação entre "COL 4" e "COL4" ficava logo abaixo do limite de aceitação. A correção foi remover os espaços em vez de juntá-los. Ela vale para qualquer rótulo que seja um bloco contínuo, como SKU, placa de carro ou código de peça: quando o reconhecimento falha num caso fácil, a normalização é a primeira suspeita.
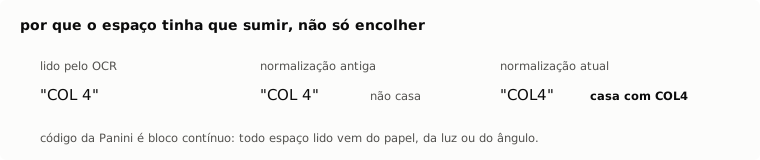
A normalização antiga e a atual para o mesmo texto lido. O segundo é sobre o limite do automático. Uma rede de fast food distribui figurinhas promocionais com a mesma numeração das regulares. O reconhecimento escolhia entre as duas por pontuação de semelhança e às vezes acertava. Ao investigar os erros, descobri que o verso das duas é idêntico. Só a frente diferencia. Nenhum ajuste de limiar resolveria, porque a informação não está na imagem. Tirei esses códigos do dicionário do reconhecedor, o backend deixou de emiti-los automaticamente e a escolha passou a ser um botão no app, que a pessoa aperta olhando a frente da figurinha. Ensinar o sistema a não adivinhar deu mais trabalho do que ensinar a adivinhar, mas um palpite errado apresentado como certo custa mais do que uma pergunta ao usuário. Resultados
|
« Tópico anterior: Cartão de visita sem framework Próximo tópico: Anatomia de três choques »