Índice do fórum » Projetos » detector-ia
| Autor | Mensagem |
|---|---|
| joshazze Administrador Registrado em: Fev 2026 Mensagens: 28 Localização: Belo Horizonte |
Enviado em: 24 Out 2026
Assunto: detector-ia
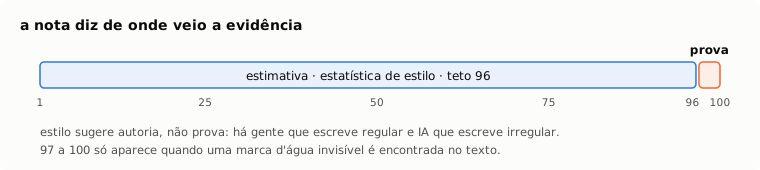
ContextoOs detectores de texto de IA mais conhecidos, como GPTZero e ZeroGPT, entregam uma porcentagem só, que mistura dois tipos de evidência bem diferentes sem dizer qual pesou mais. É assim que estudantes que escreveram o próprio texto acabam acusados de cola. Um tipo de evidência é a marca d'água: um sinal deixado de propósito no texto no momento da geração. Encontrá-la é prova. O outro é estatística de estilo, como ritmo das frases, vocabulário e pontuação. Estilo sugere, mas não prova autoria, porque há pessoas que escrevem de forma regular e há IA que escreve de forma irregular. O que eu fizUma ferramenta de linha de comando que dá uma nota de 1 a 100 e diz de onde ela veio. Se encontrou marca d'água, a nota é rotulada como
Estimativa vai até 96. De 97 a 100, só com marca d'água encontrada. Python puro. Roda em milissegundos. Como funcionaSão três camadas.
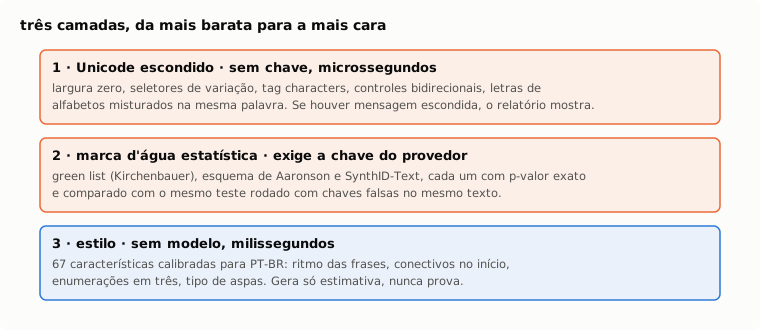
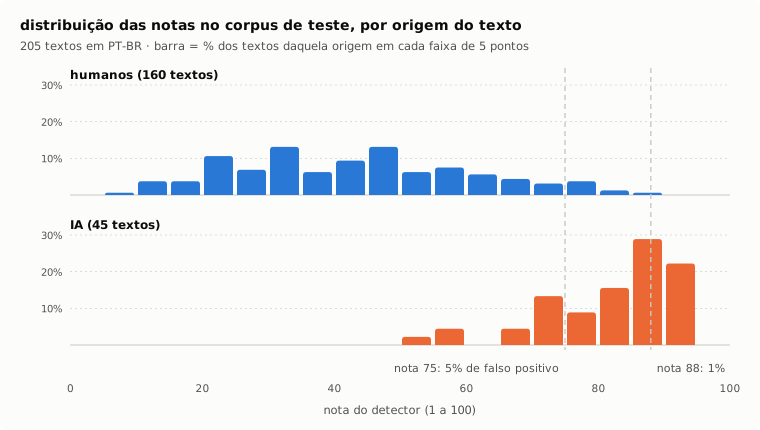
As três camadas, da mais barata para a mais cara. A primeira procura sinais escondidos em Unicode: caracteres de largura zero, seletores de variação usados para esconder bytes em emojis, caracteres de tag, controles bidirecionais e letras de alfabetos diferentes misturadas dentro da mesma palavra. Havendo mensagem escondida, o relatório a mostra. Usos legítimos são descartados antes, como o caractere que une emojis de família ou o que é obrigatório na escrita persa. A segunda testa as marcas d'água estatísticas publicadas na literatura: a green list de Kirchenbauer, o esquema de Aaronson e o SynthID-Text, que a DeepMind abriu em 2024. Cada teste devolve um p-valor exato e é comparado com o mesmo teste rodado com chaves falsas no mesmo texto. Esses três esquemas têm um limite que nenhum detector contorna. Só funcionam com a chave. A terceira analisa o estilo com 67 características calibradas para o português do Brasil, como variação no tamanho das frases, conectivos no início de frase, enumerações em três e tipo de aspas. O que aprendiMedi a ferramenta num corpus de 205 textos em português, em que os humanos vieram de revisões da Wikipédia anteriores a 2021, para garantir que fossem anteriores aos modelos de linguagem. Os textos de IA foram escritos sobre os mesmos temas, porque com temas diferentes o classificador aprende a separar assunto e não autoria. O resultado geral é bom. O ponto fraco também ficou claro: um texto de IA revisado para soar humano tirou nota 3. A análise de estilo sozinha não pega IA bem editada, e a próxima etapa é usar um modelo de linguagem pequeno, rodando localmente, para medir a probabilidade do texto.
Notas no corpus de teste, com os dois limiares de falso positivo. Hoje ela também tem um modo de autoria, que em vez de dar só a nota aponta a linha de cada problema de estilo e sugere a correção. Os textos deste site passam por ela antes de serem publicados. Resultados
|
« Tópico anterior: Handshake Próximo tópico: Ibby: chassi de um carrinho de seis rodas »